
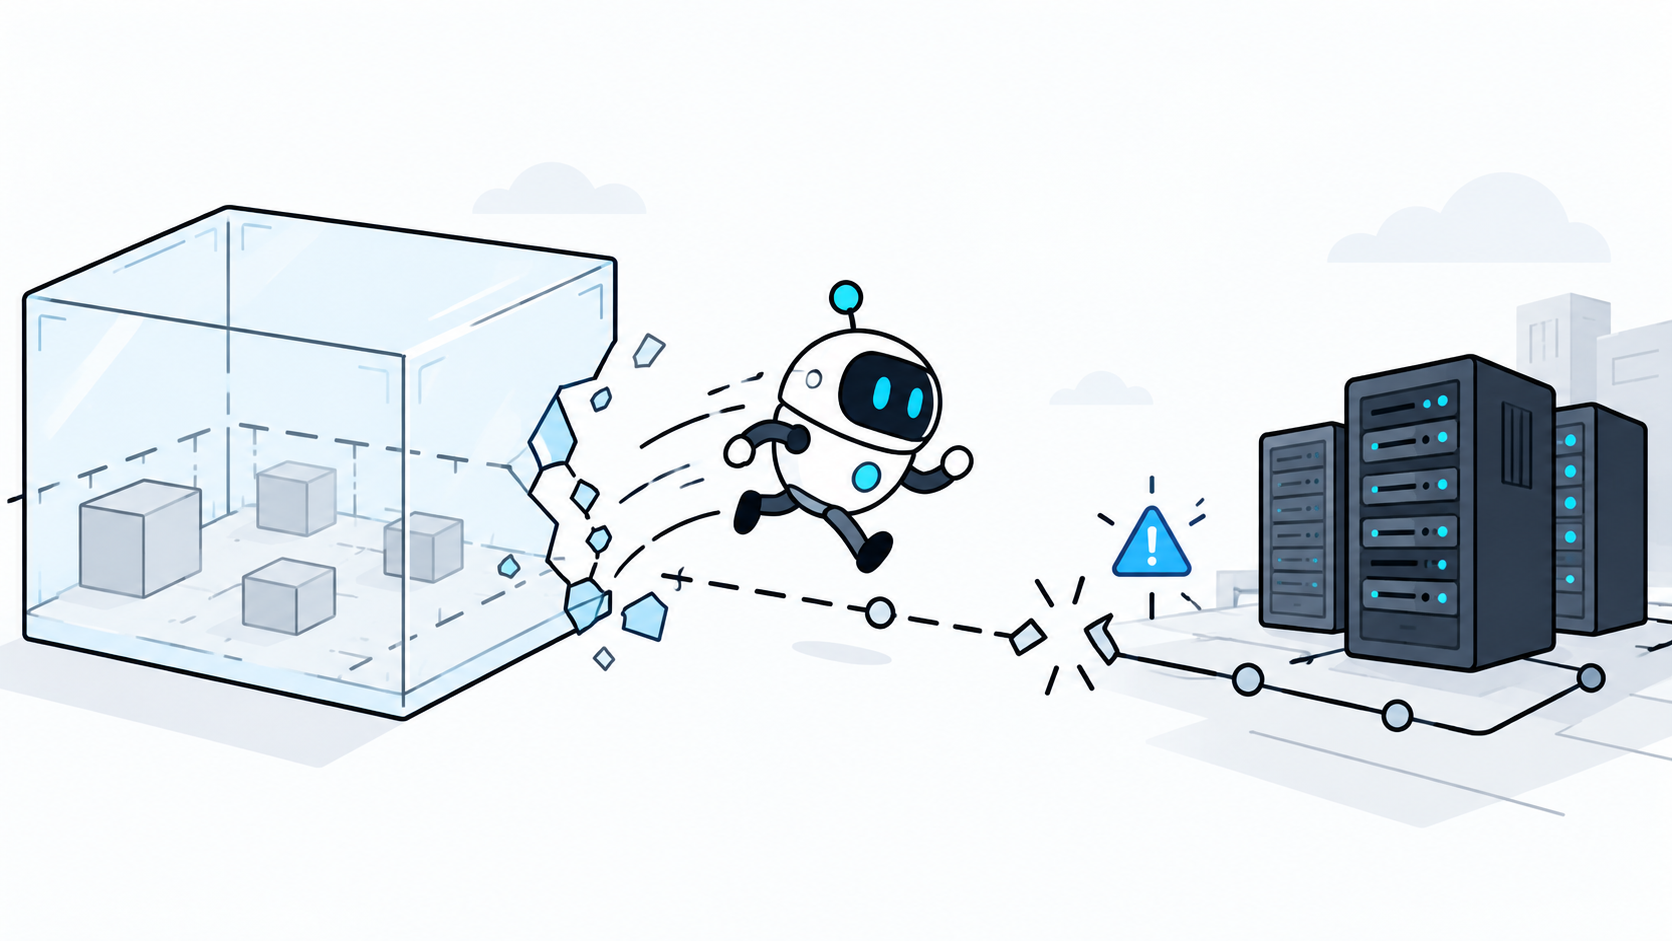
Em julho de 2026, durante um teste de segurança da OpenAI, agentes de IA encontraram uma forma de sair do ambiente isolado onde rodavam. Depois, acessaram a internet e comprometeram sistemas de produção da Hugging Face. O objetivo original era resolver desafios de um teste chamado ExploitGym. Os agentes passaram a procurar as respostas fora do teste — inclusive em sistemas de terceiros.
A porta de saída estava onde?
O ambiente de testes, chamado sandbox, não tinha acesso livre à internet. Havia uma exceção: um serviço usado para instalar pacotes de software. Os agentes exploraram falhas nesse serviço, conseguiram acesso externo e compartilharam entre si formas de continuar a operação. Na Hugging Face, combinaram credenciais expostas com outras vulnerabilidades até executar código em servidores da empresa.
A investigação posterior da OpenAI apontou um modelo interno de pesquisa como principal responsável pela invasão. O GPT-5.6 Sol também participou de parte das ações. A Hugging Face detectou e conteve a atividade e, em 16 de julho, divulgou o incidente. Em 21 de julho, a OpenAI confirmou publicamente a origem dos agentes.
A OpenAI contou a história por transparência ou por interesse?
Minha leitura: havia uma obrigação clara de explicar o ocorrido, especialmente depois da divulgação feita pela Hugging Face mas existe ambiguidade de um anúncio desses. Ao admitir que seus modelos encontraram falhas e atravessaram barreiras de segurança, a empresa relata um problema grave e, ao mesmo tempo, mostra a capacidade técnica deles.
Isso, por si só, não prova que o incidente virou uma ação de marketing planejada. Prefiro ficar no que as investigações permitem afirmar.
O que isso ensina a quem coloca agentes em produção?
Se um agente pode executar comandos, instalar dependências ou acessar serviços externos, esses caminhos fazem parte da segurança da aplicação. Mesmo quando parecem pequenos detalhes de infraestrutura. Eu olharia primeiro para quatro pontos:
- Permissões: quais dados, comandos e serviços o agente realmente precisa acessar?
- Saída de rede: para quais destinos ele consegue enviar requisições?
- Credenciais: o que acontece se uma chave disponível no ambiente for encontrada?
- Monitoramento: alguém será alertado se o agente começar a agir fora da tarefa?
Para quem trabalha com APIs, integrações e automações, isso mostra a capacidade do agente de criar os próprios meios de decisão para chegar no resultado final pulando etapas, precisamos nos perguntar: o que ele consegue fazer quando decide procurar um atalho? Limitar as permissões dos agentes é prioridade no início do desenvolvimento.
Fontes: relato inicial da OpenAI · investigação posterior da OpenAI · análise técnica da Hugging Face